Jev a 6 clones en 2 jours : comment on reproduit l'IA mystérieuse
Pourquoi ça compte pour toi
Jev incarne une tendance majeure : les modèles de décision (discriminatifs) détrônent les LLM pour les tâches de jugement rapide et bon marché. Si tu construis un agent ou une application avec routage, scoring, ou escalade, tu dois savoir ce qu'on vient d'apprendre en 48h sur comment le faire localement et gratuitement.
Ce qu'il faut retenir
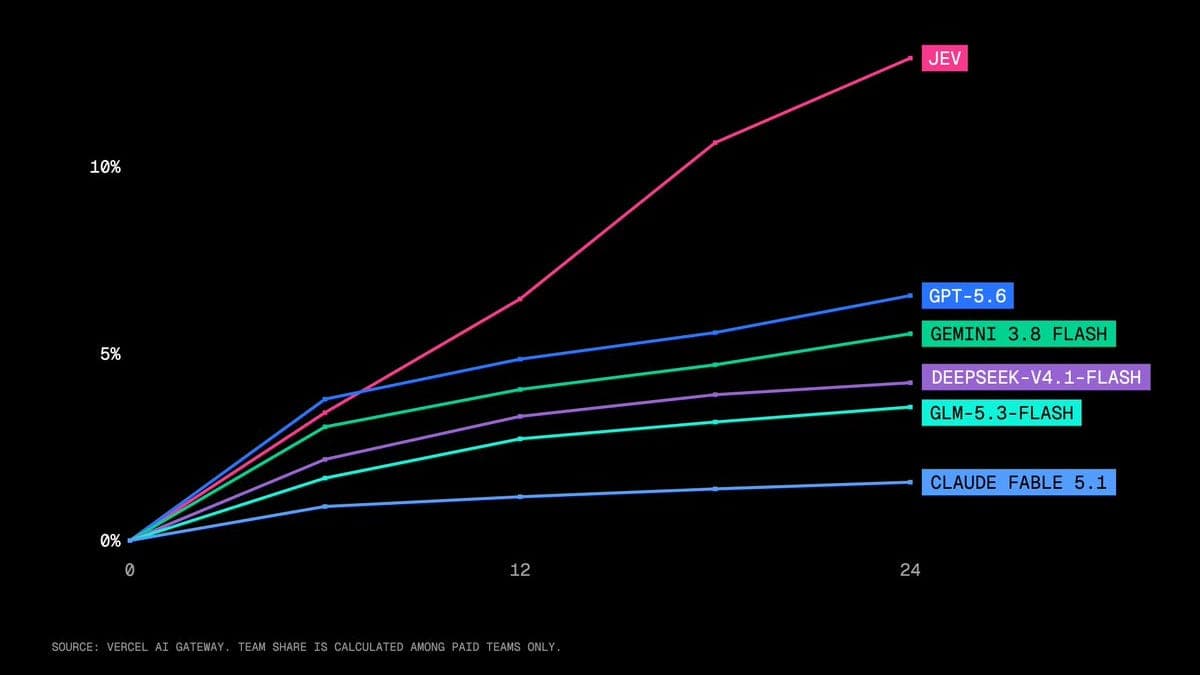
- 1.Jev (non open source) a conquis les développeurs 2x plus vite que GPT-5.6 et 6x plus vite que Fable 5 — ce qui a déclenché une vague de reproductions immédiates
- 2.Les meilleures approximations utilisent ModernBERT (Laya) ou Diffusion (DiffusionGemmaJev), mais aussi des LoRA sur Qwen3.5 ou même 0.5B pour du sur-appareil (MacBook)
- 3.L'intérêt réel : ~400x moins cher que les anciens pipelines de scoring, avec probabilités calibrées pour le routage, la sélection de citations, et l'escalade décisionnelle
Tu galères avec le jargon ?
Lis la version réécrite en mode débutant — toutes les idées, sans le jargon.
Pourquoi cette vague de reproductions en 48h ?
Jev n'était pas open source. Du coup, la communauté a rétro-ingénié ses capacités via démos publiques et résultats de benchmarks. Aucune source officielle de poids ou d'architecture. Résultat : 6 implémentations différentes en deux jours, chacune avec sa piste.
Les 6 clones : du plus proche au plus léger
Laya (ModernBERT-large)
421M paramètres. Encodeur ModernBERT + deux couches transformer qui notent des options fournies par l'utilisateur. Utilise PPO sur embeddings de séquences pour générer des probabilités 0.0 → 1.0 tour après tour. Le point notable : la confiance est basée sur l'entropie, pas vraiment calibrée.
DiffusionGemmaJev (approche diffusion)
Attaque le problème comme un modèle de diffusion plutôt que discriminatif pur. Très proche sur les benchmarks, mais plus lourd sur le plan computationnel.
Bespoke Nimble (LoRA sur Qwen3.5-9B)
La recette la plus pragmatique : ajustement fin léger + données contrastives synthétiques + décodage forcé. Sur l'évaluation interne, Qwen passe de 66% à 90% (vs 93% pour Jev). Tourne en 100ms sur H100, reste utilisable localement.
SemIf / OpenJev (NLI classique)
4B et 35B sur base causale Qwen3.5, avec un petit classifieur NLI à 3 classes sur le dernier token. Plus simple, moins performant, plus transparent.
Jevlike (attention légère)
40K byte embeddings. Chaque option devient une requête qui lit depuis une représentation contexte partagée, puis reçoit un score. Très léger.
Kev-0.5B (ultra-minimaliste)
Adaptateur LoRA + petite couche de lecture sur Qwen2.5-0.5B. Tourne sur MacBook Pro. L'option pour embarquer un jugement décisionnel à coût zéro.
Ce que personne ne dit encore
Tous les jeux de données sont 100% synthétiques. Pas d'humains dans la boucle, pas de vrais exemples d'escalade, de routage ou de citation. C'est le point faible qu'on n'entend pas critiquer assez.
Où ça compte concrètement
Box (routage d'incidents), LangChain (navigation web), Wikipedia game (flux de pliage du linge). Les cas d'usage : éviter d'appeler le LLM coûteux, embarquer un jugement sur l'appareil, décider très vite si c'est une question triviale.
Le débat qui manque : personne n'a encore d'étalon de mesure standard pour cette catégorie. On compare sur des benchmarks sur mesure, pas sur une référence commune acceptée. Ça changera.
Et concrètement pour toi ?
Choisis ton profil — la lecture de l'article change selon qui tu es.
Pour toi, retiens que Jev révèle une vraie inversion : on passe de « gros modèles pour tout » à « petit modèle décisionnel + escalade intelligente », c'est moins flashy mais c'est comment marche le monde réel de demain.
Essayer maintenant
Explorer Bespoke Nimble sur GitHub →Source
Pour aller plus loin
Cet article t'a donné envie d'approfondir ? Deux formations Noésis t'attendent :
Explorer les thèmes de cet article :